Created: 19 Apr 2024
Last updated: 18 Sep 2024
Out-of-Distribution
Der Begriff “Out-of-Distribution” (OOD) bezieht sich im Machine Learning auf Datenpunkte oder Muster, die sich signifikant von den Trainingsdaten unterscheiden, auf denen ein KI-Modell trainiert wurde.
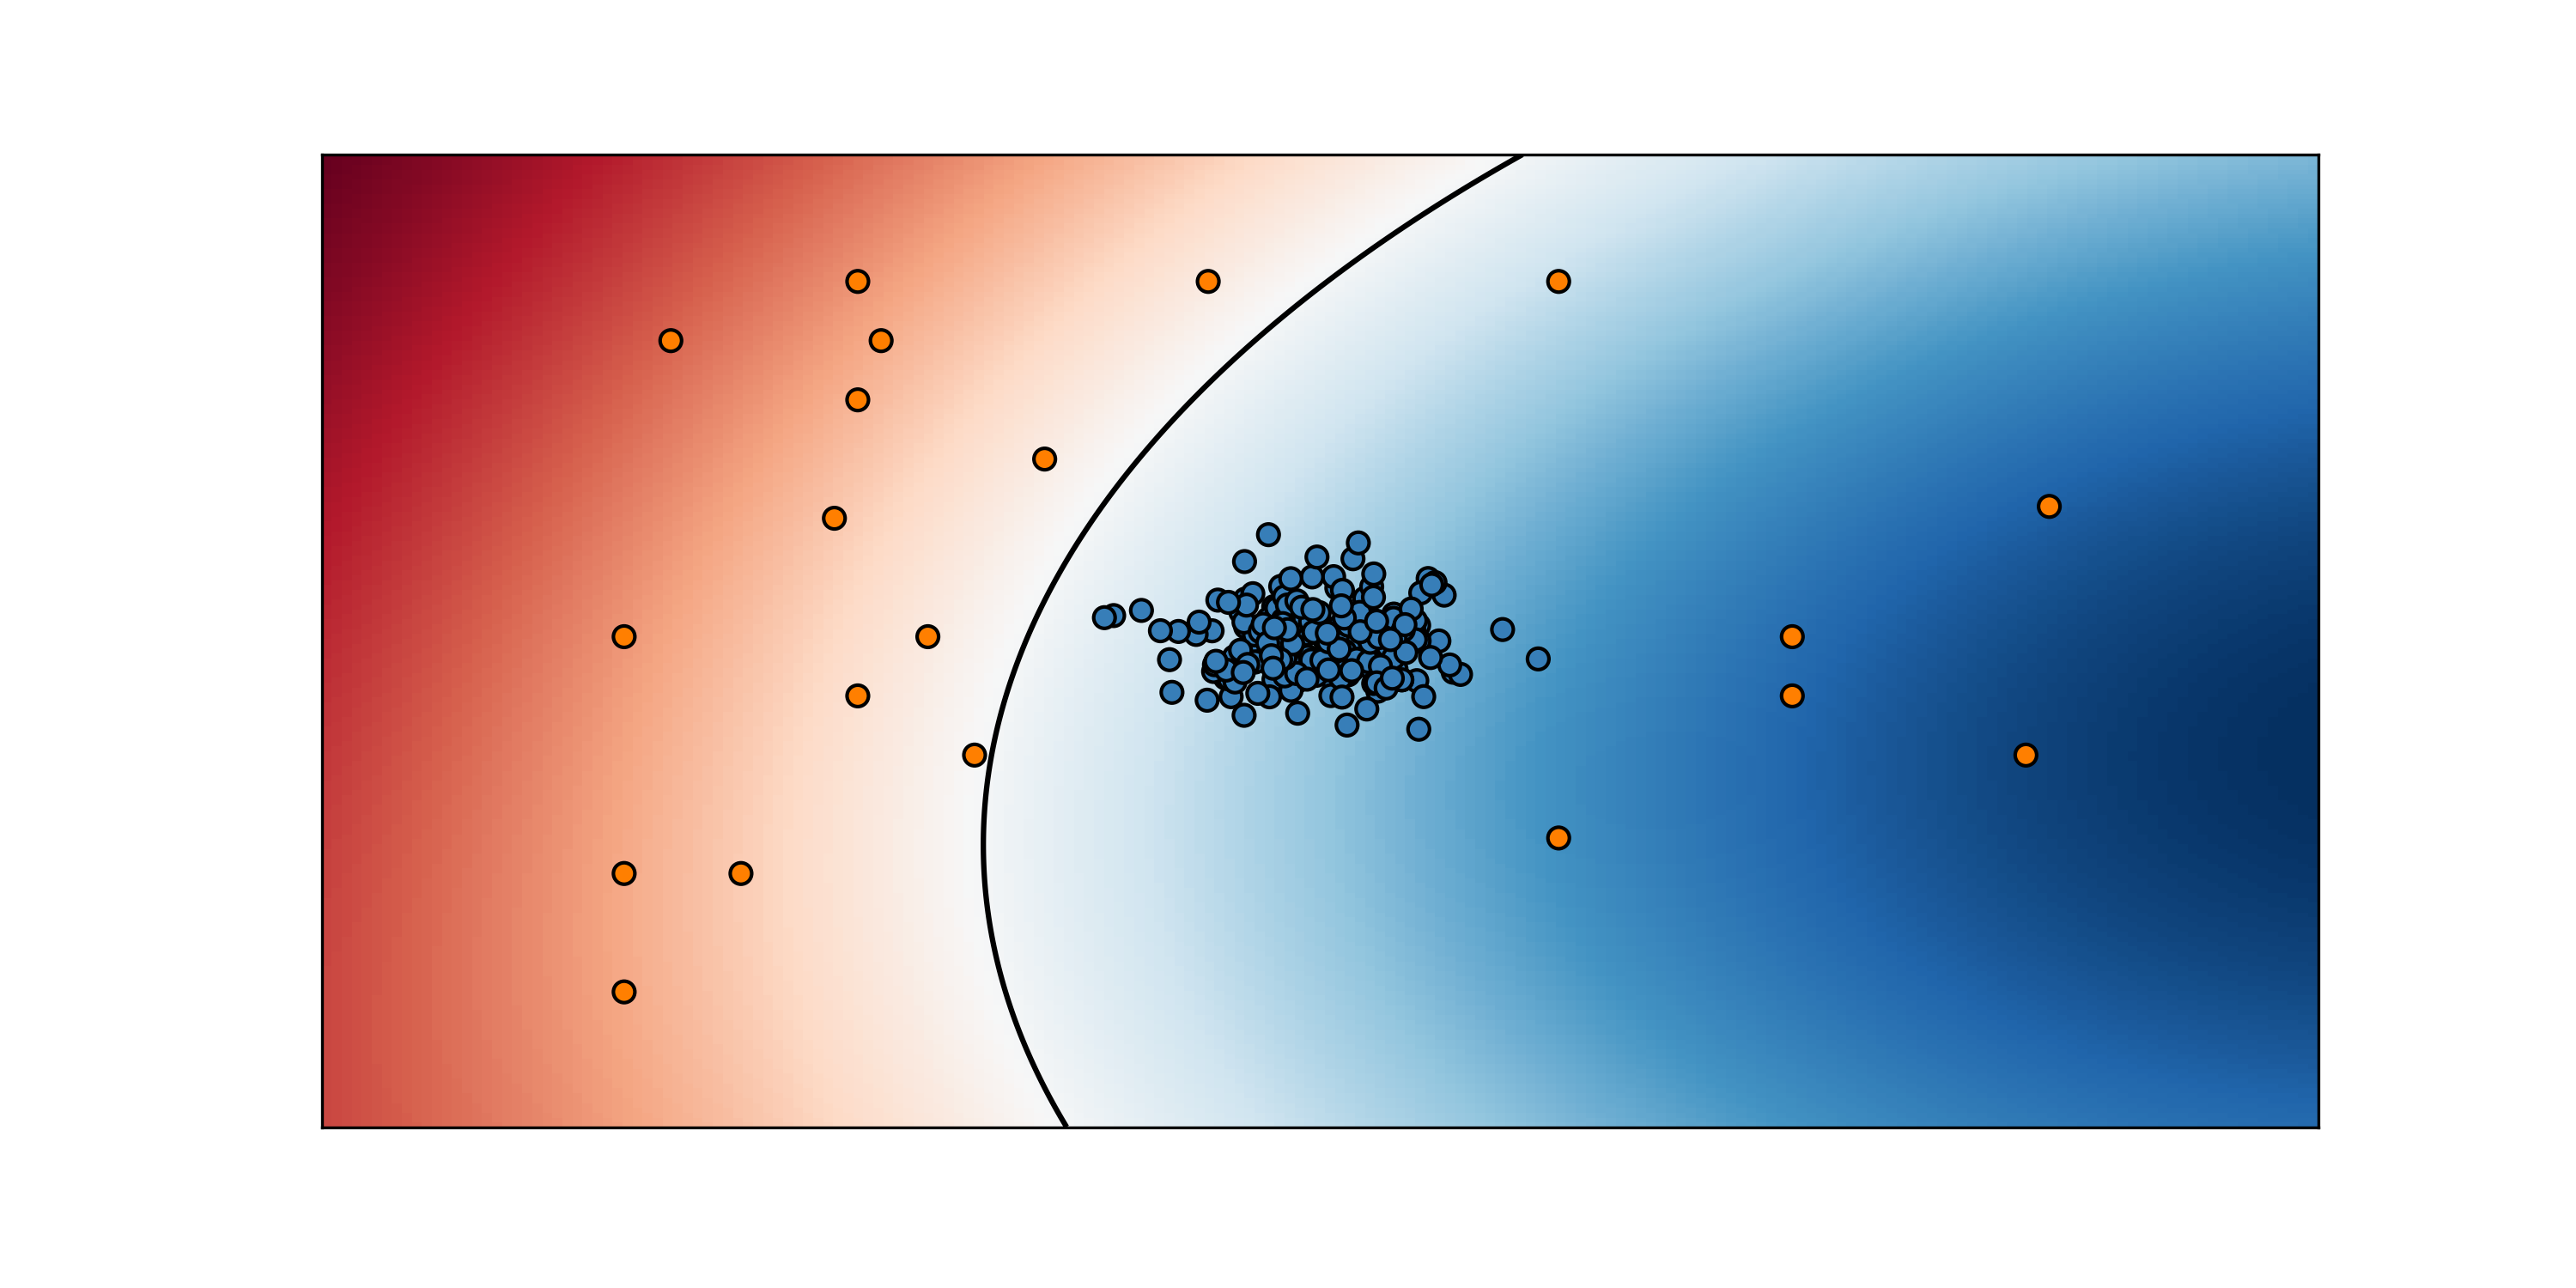
Dies kann zu Problemen führen, da das Modell möglicherweise nicht in der Lage ist, angemessene Vorhersagen oder Entscheidungen für diese ungewohnten Daten zu treffen. Es werden falsche Vorhersagen mit übermäßigem Vertrauen getroffen:
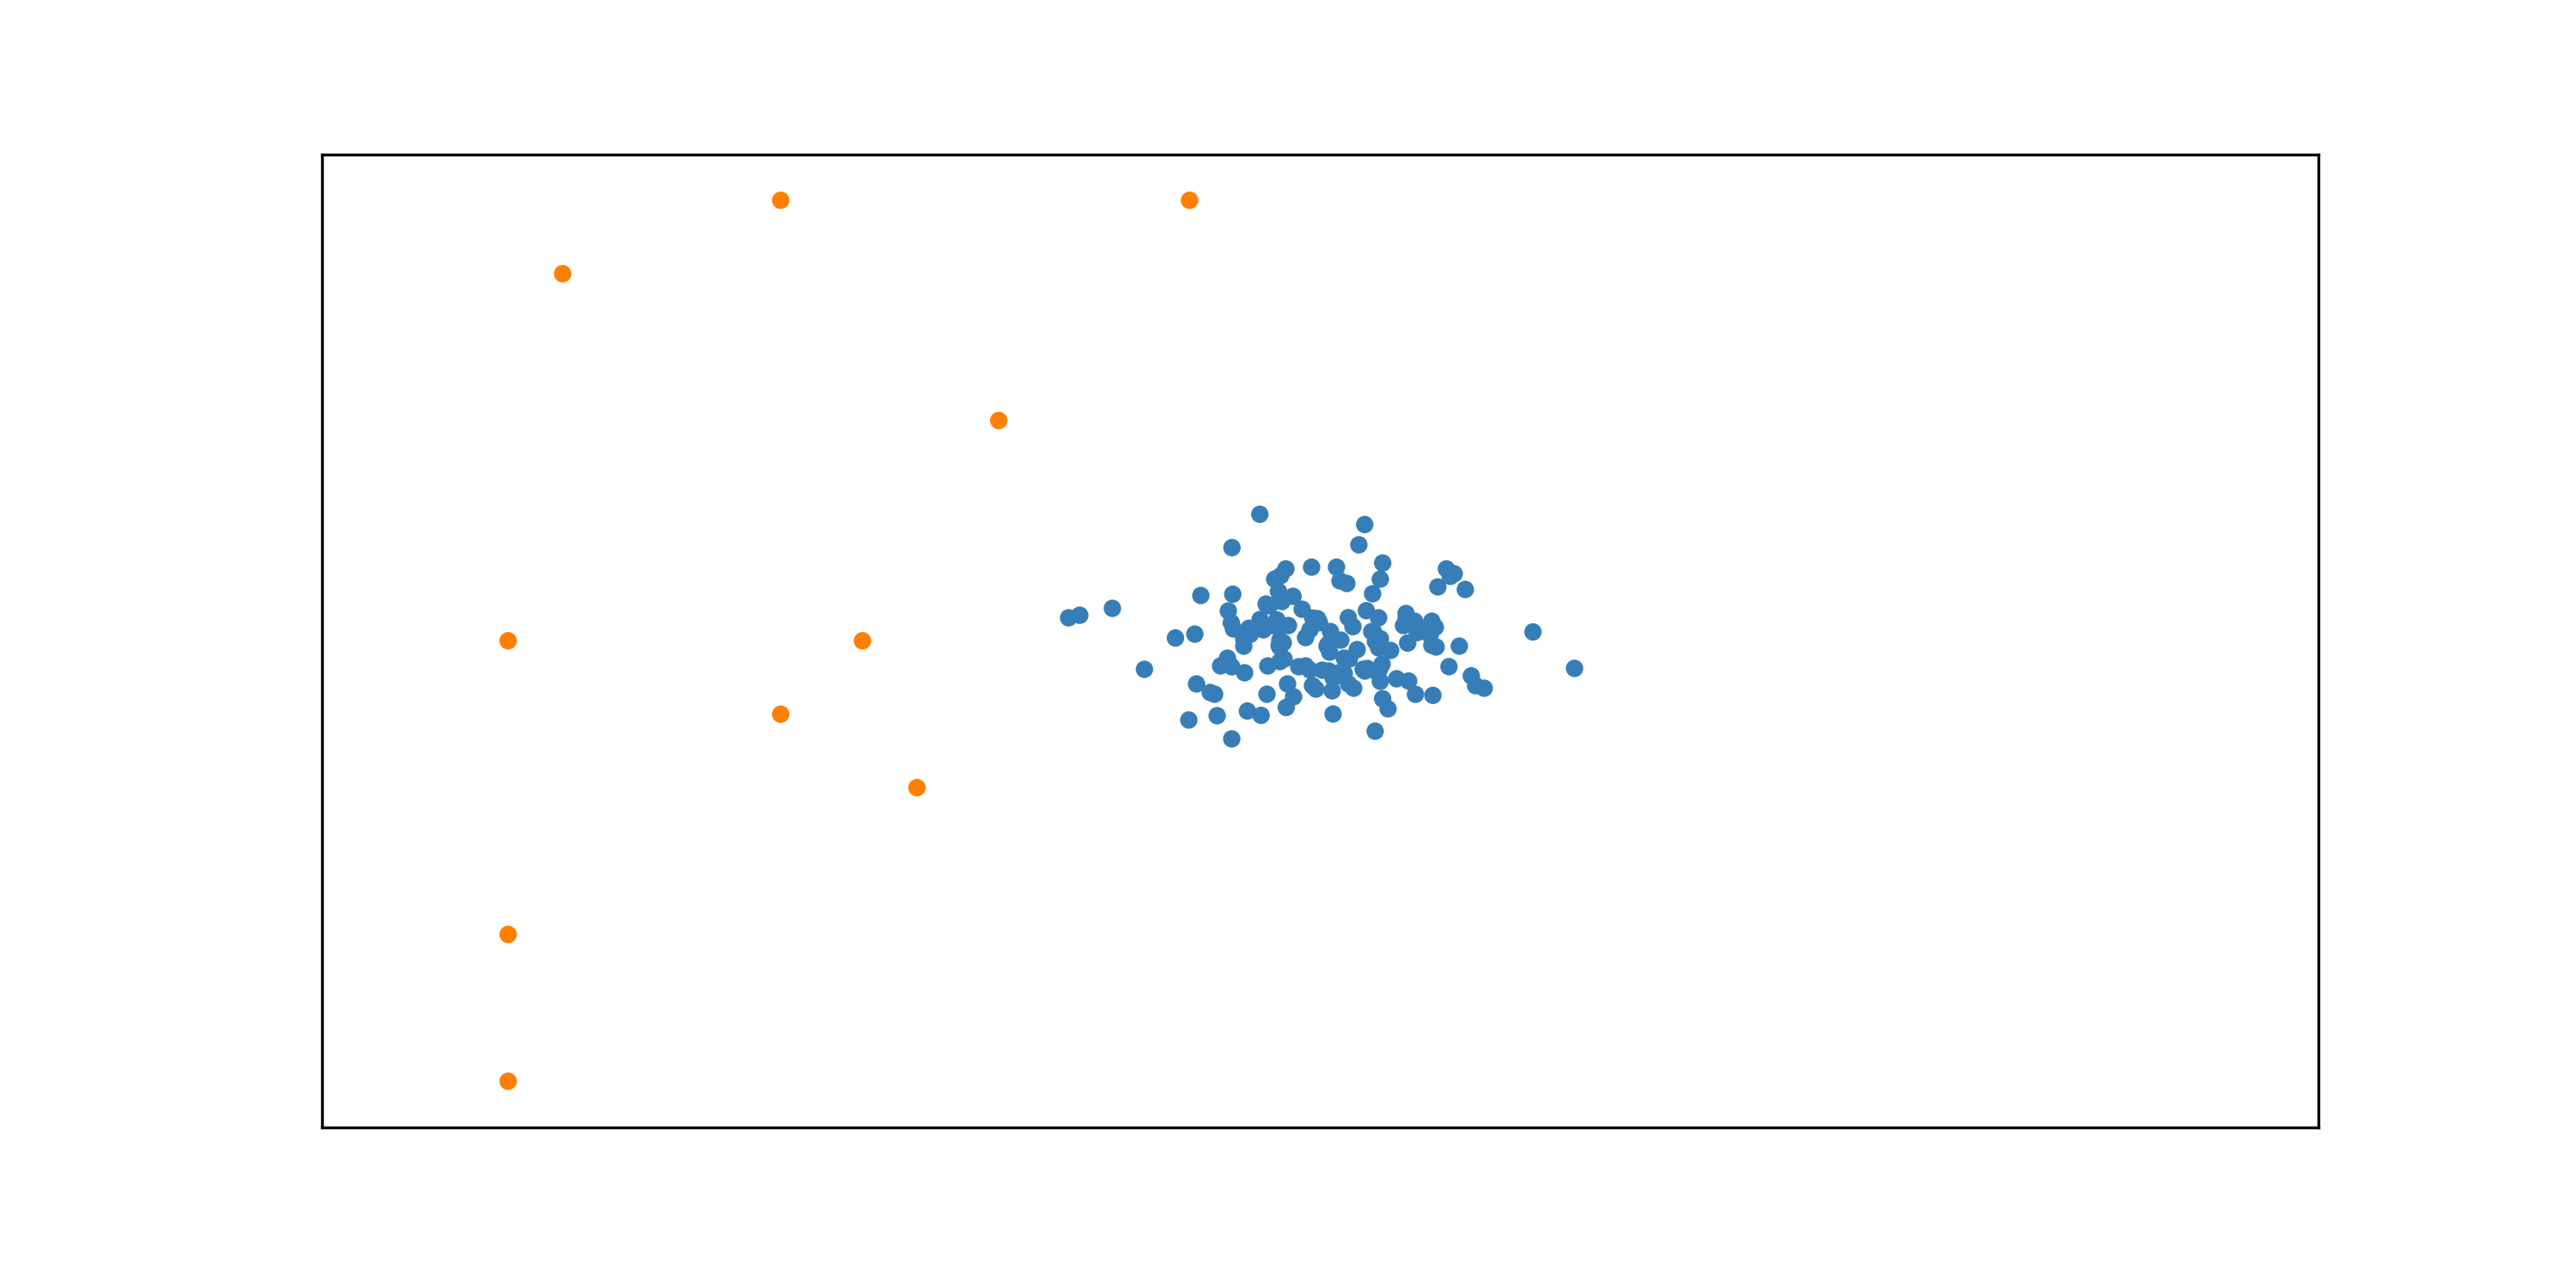
- Hier ein Beispiel eines Datensatzes mit 2 verschiedenen Klassen:
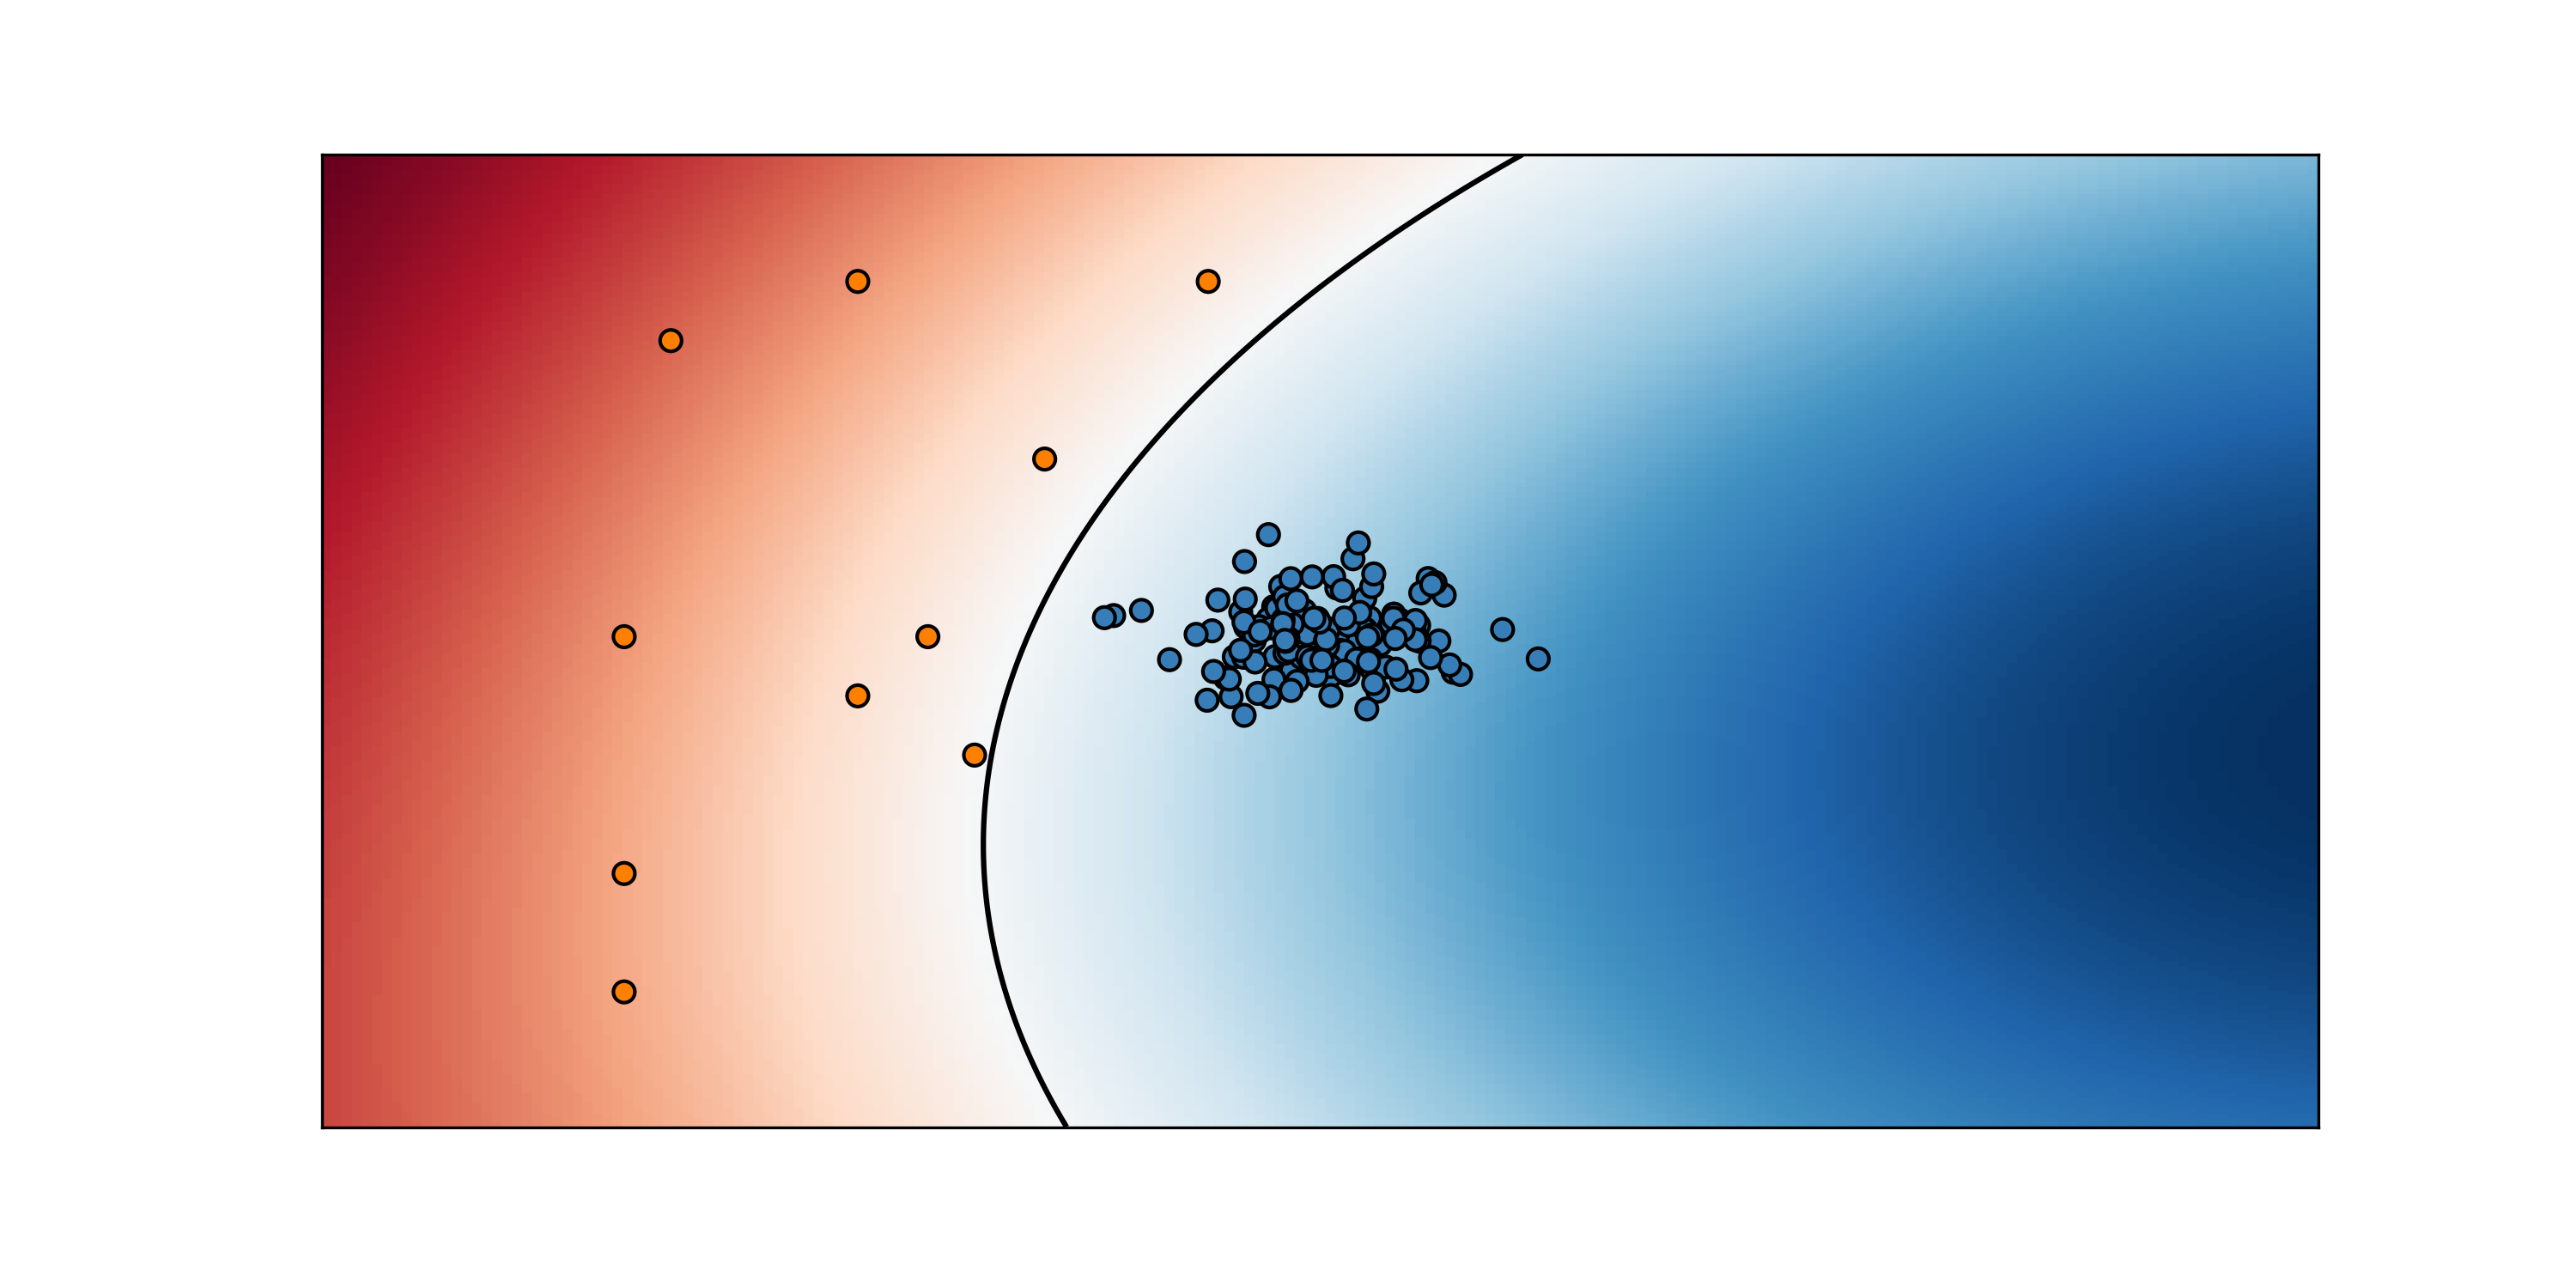
- Trainieren wir eine KI damit, erhalten wir womöglich folgende Decision Boundary:
- Setzen wir die KI jedoch ein, um neue Datenpunkte zu klassifizieren, könnten wir Probleme erhalten:
Um diese Probleme zu vermeiden, gibt es verschiedene Ansätze zur Out-of-Distribution Detection:
- Maximum Softmax Probability: (see
Hendrycks & Gimpel, 2017)
- Typischerweise gibt ein Modell höhere Softmax-Wahrscheinlichkeiten für In-Distribution-Daten und niedrigere Wahrscheinlichkeiten für OOD-Daten aus. Durch Festlegen eines Schwellenwertes für diese Wahrscheinlichkeiten können Instanzen unterhalb des Schwellenwerts als potenzielle OOD-Instanzen markiert werden.
- Ensembling von mehreren Modellen:
- Ensembling bedeutet die Nutzung mehrerer Modelle zur Vorhersage. Während einzelne Modelle unsicher über eine OOD-Instanz sein können, kann ihre kollektive Entscheidung zuverlässiger sein. Durch Vergleich der Ausgaben verschiedener Modelle können Vorhersageabweichungen identifiziert werden, die auf OOD-Daten hinweisen können.
- Temperature Scaling:
- Modelle geben zusammen mit Vorhersagen in der Klassifikation “confidence”-Werte aus. Idealerweise sollten diese confidence mit der tatsächlichen Wahrscheinlichkeit der Korrektheit übereinstimmen:
- Wenn wir zum Beispiel 100 Vorhersagen mit 80% confidence haben, erwarten wir, dass 80% der Vorhersagen tatsächlich korrekt sind. Wenn dies der Fall ist, kann man sagen, dass das Netzwerk kalibriert ist.
- Temperatur-Skalierung ist eine Post-Processing-Methode, die die Softmax-Ausgaben eines Modells kalibriert.
- Durch Anpassen des “Temperatur”-Parameters kann die confidence der Vorhersagen des Modells verändert werden. Korrekt kalibrierte Modelle können genauere Unsicherheitsschätzungen liefern, die bei der OOD-Erkennung helfen.
- Modelle geben zusammen mit Vorhersagen in der Klassifikation “confidence”-Werte aus. Idealerweise sollten diese confidence mit der tatsächlichen Wahrscheinlichkeit der Korrektheit übereinstimmen:
- Training eines binären Klassifikationsmodells als Kalibrator:
- Ein weiterer Ansatz besteht darin, ein separates binäres Klassifikationsmodell zu trainieren, das als Kalibrator fungiert. Dieses Modell wird darauf trainiert, zwischen In-Distribution und OOD-Daten zu gunterscheiden. Indem die Ausgaben des primären Modells in diesen Kalibrator eingespeist werden, kann eine binäre Entscheidung darüber erhalten werden, ob die Instanz in Distribution oder OOD ist.
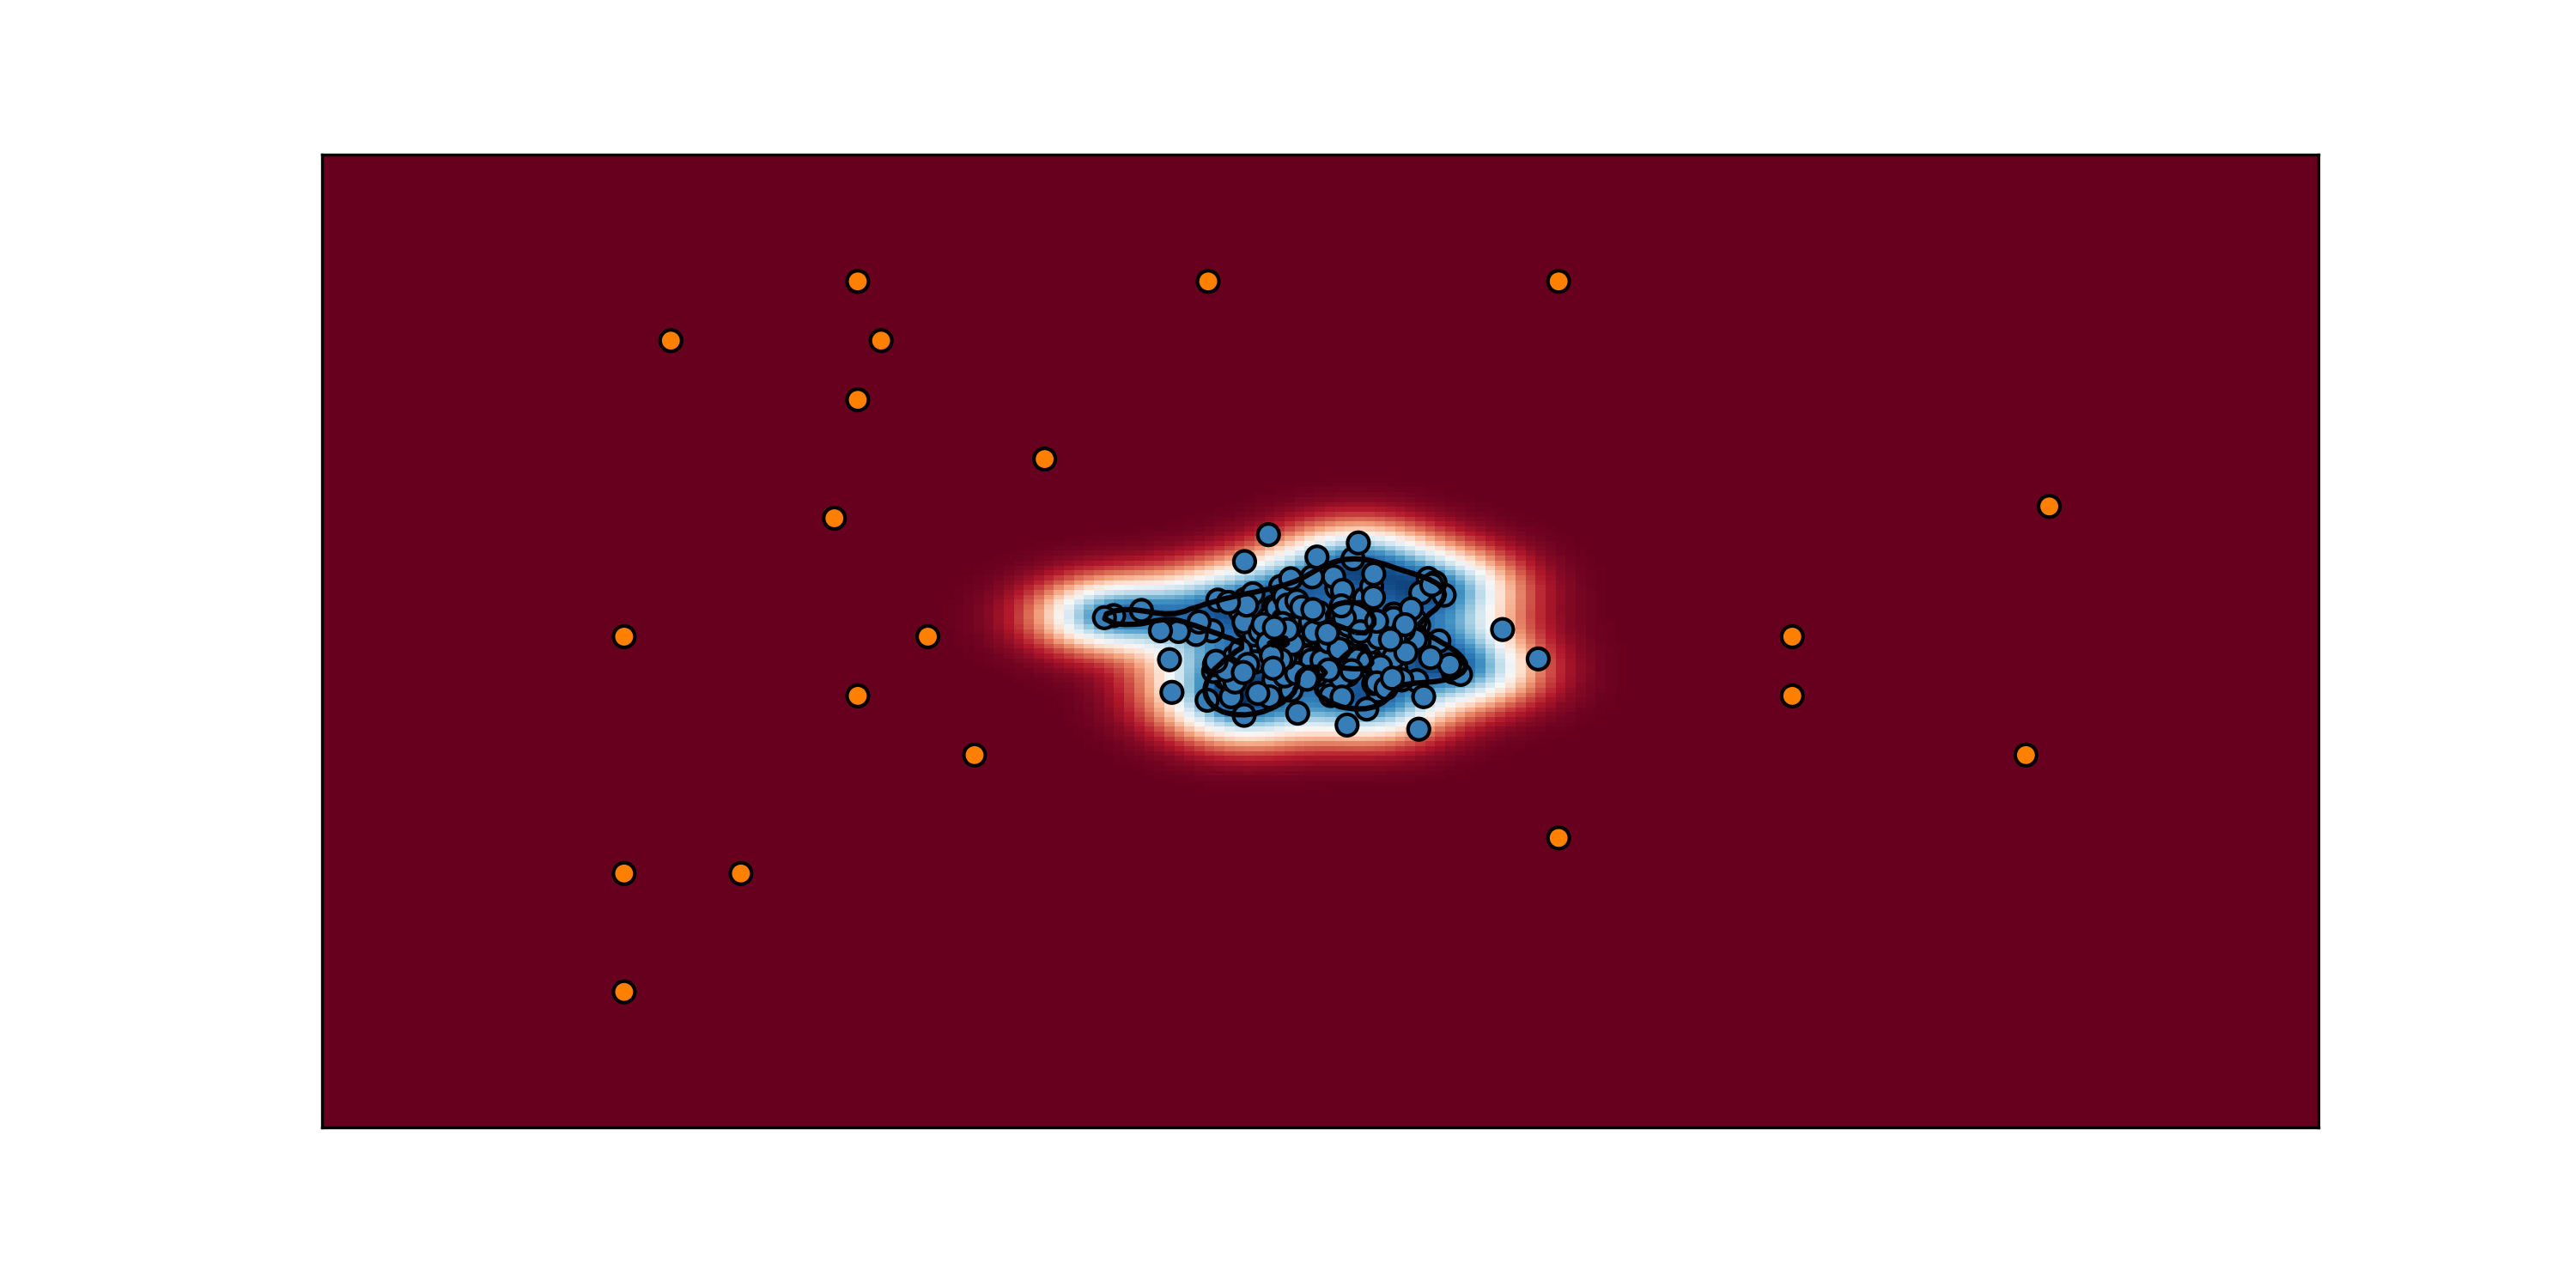
- Anstatt eines binären Klassifikators kann auch eine One-Class Support Vector Machine (SVM) eingesetzt werden, welche eine Outlier Boundary um die “normale” Klasse herum definiert:
- Monte-Carlo Dropout:
- Dropout ist eine Methode zur Regularisierung, die häufig in neuronalen Netzwerken verwendet wird. Monte-Carlo Dropout beinhaltet das Durchführen von Dropout zur Inferenzzeit und das Ausführen des Modells mehrmals. Die Varianz in den Ausgaben des Modells über diese Durchläufe hinweg kann eine Schätzung der Unsicherheit des Modells liefern, die zur Erkennung von OOD-Instanzen verwendet werden kann.
- …